Cómo explicarle el decaimiento orbital a una regresión lineal
Un satélite en órbita baja está cayendo. Despacio, pero está cayendo.
Existe una fórmula clásica que predice a qué velocidad, y está en los libros desde hace décadas. Al terminar el curso Supervised Machine Learning: Regression and Classification de Andrew Ng, quise responder algo concreto: ¿podía el modelo más simple de ese curso, una regresión lineal múltiple entrenada con gradient descent, superar a la fórmula?
La respuesta corta es que sí, en un régimen particular y por un margen amplio.
La respuesta interesante es que llegar hasta ahí casi no tuvo que ver con el algoritmo. Nunca lo cambié. Lo que cambió, tres veces, fue qué decidí contarle al modelo sobre el mundo.
Por qué cae un satélite#
Solemos imaginar el espacio como vacío, y a 300 kilómetros casi lo es. El aire que hay allá arriba es aproximadamente una cienmilmillonésima parte del que estás respirando ahora.
Pero el satélite lo atraviesa a 7,7 kilómetros por segundo, y nunca se detiene. A lo largo de semanas y meses, ese susurro de atmósfera se acumula.
La fuerza de arrastre es la misma de cualquier curso de mecánica de fluidos:
$$F_D = \tfrac{1}{2}\rho v^{2} C_D A$$
Lo que importa para la trayectoria no es la fuerza sino la fuerza por unidad de masa, y al dividir, todas las propiedades del vehículo colapsan en un único número. Se llama coeficiente balístico:
$$\beta = \frac{m}{C_D A}$$
Pensalo como qué tan bien un objeto ignora al aire. Un satélite denso y compacto tiene β alto y se sacude la atmósfera de encima. Un CubeSat liviano con los paneles desplegados tiene β bajo y una vida mucho más corta. En las simulaciones que siguen, β va de 50 a 400 kg/m².
Y acá viene la parte que sorprende a casi todo el mundo la primera vez.
El arrastre le saca energía a la órbita. La energía orbital específica es
$$\varepsilon = -\frac{\mu}{2a}$$
así que perder energía vuelve a ε más negativo, y eso hace que el semieje mayor a se achique. La órbita se encoge. Pero la velocidad orbital va como la inversa de la raíz de a, lo que significa que a medida que el satélite pierde energía, se mueve más rápido.
El arrastre es un freno que te acelera. El truco está en que el satélite cambia altura por velocidad: la energía potencial baja aproximadamente al doble de la velocidad a la que sube la cinética, y la diferencia es lo que la atmósfera se lleva como calor.
Si igualás la potencia disipada por el arrastre a la tasa de cambio de la energía orbital, aparece la ecuación alrededor de la cual gira todo este proyecto:
$$\frac{da}{dt} = -\sqrt{\mu a}\left(\frac{v_{rel}}{v}\right)^2 \cdot \frac{\rho}{\beta}$$
Tres ingredientes. Dónde estás, qué sos, y a través de qué estás volando.
En ese último está la dificultad.
La atmósfera es la parte difícil#
La densidad atmosférica cae de forma aproximadamente exponencial con la altura, pero ninguna exponencial única sirve para todo el rango. La tasa de caída, llamada altura de escala, es de unos 7 km cerca del suelo y de 268 km a 1000 km de altura.
El modelo que usé, tomado de Fundamentals of Astrodynamics and Applications de Vallado, resuelve esto apilando 28 capas, cada una con su densidad de referencia y su propia altura de escala:
$$\rho(h) = \rho_{0,i}\exp\left(-\frac{h - h_{0,i}}{H_i}\right)$$
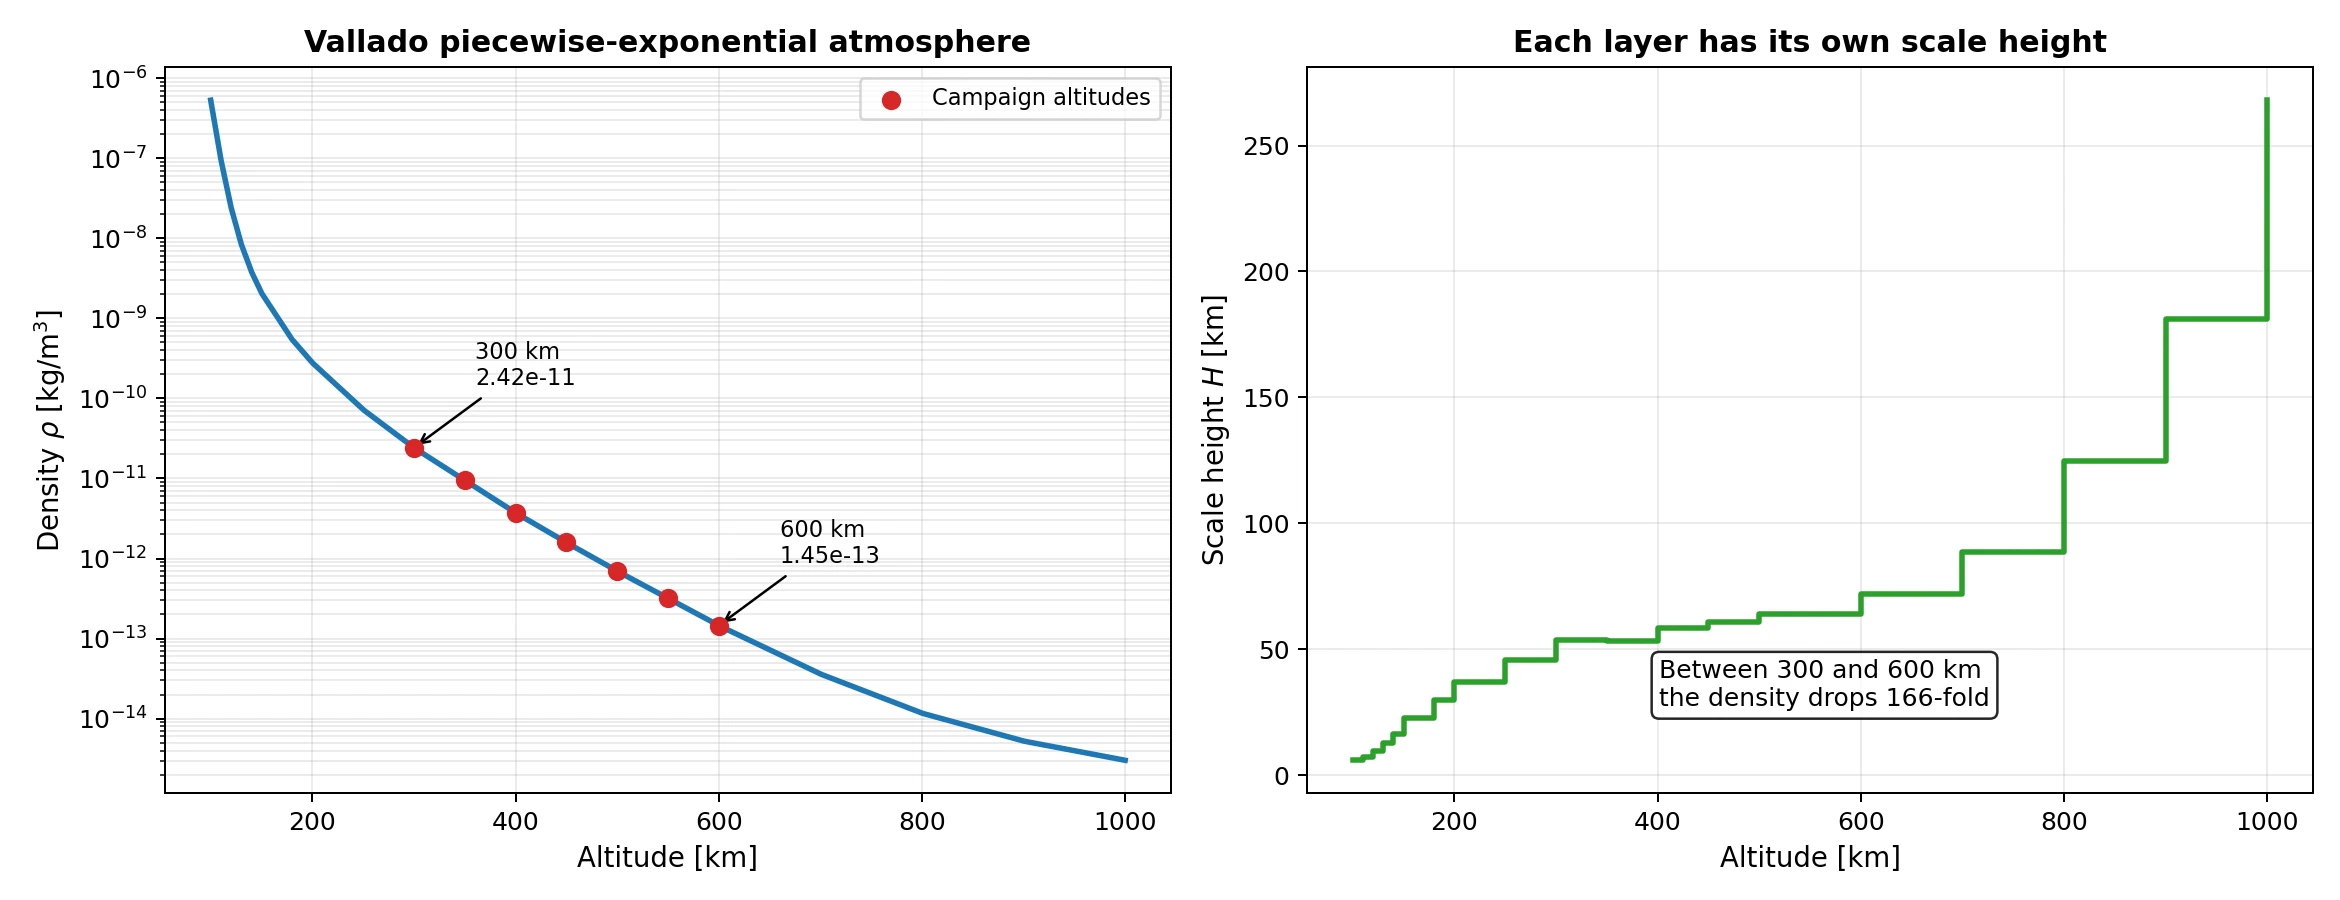
Mirá el panel izquierdo y notá que el eje vertical es logarítmico. Entre 300 y 600 kilómetros, una diferencia que podrías recorrer en auto en tres horas, la densidad cae 166 veces.
Ahora juntá las dos piezas y aparece el lazo de realimentación que define todo el fenómeno:
El satélite pierde un poco de altura. Menos altura significa aire exponencialmente más denso. Más denso significa más arrastre. Más arrastre significa que pierde altura más rápido. Lo que significa aire todavía más denso.
El decaimiento orbital no es lineal, y ni siquiera es exponencial. Es lento, lento, lento, y después una pared. Esa forma va a importar enormemente en un momento.
La fórmula que quería superar#
La ecuación diferencial de arriba tiene solución cerrada, siempre que estés dispuesto a congelar una cosa.
Sustituyendo la raíz de a, la ecuación se vuelve maravillosamente simple:
$$\frac{d\sqrt{a}}{dt} = -\frac{\rho}{2\beta}\sqrt{\mu}$$
Si ρ es constante, el lado derecho es constante, y una constante se integra en un renglón:
$$\sqrt{a(t)} = \sqrt{a_0} - \frac{\rho_0}{2\beta}\sqrt{\mu}\left(\frac{v_{rel}}{v}\right)^{2}t$$
El último factor tiene en cuenta la velocidad del satélite relativa a la atmósfera, que rota junto con la Tierra.
Es una buena fórmula. Es la referencia contra la cual cualquier modelo de machine learning tiene que justificarse. En la práctica nadie la usaría en un único paso de 90 días a baja altura (se integraría paso a paso), pero mi objetivo no era reemplazar un integrador numérico, sino ver si un modelo estático de un solo paso podía capturar el decaimiento acumulado de golpe. En este experimento, su densidad viene del mismo modelo de Vallado usado en el simulador, pero queda congelada en la altura inicial durante toda la predicción.
Pero mirá bien la suposición. Mantiene ρ fija en su valor inicial durante toda la propagación, y ρ es justamente la cantidad que acabamos de ver que se dispara.
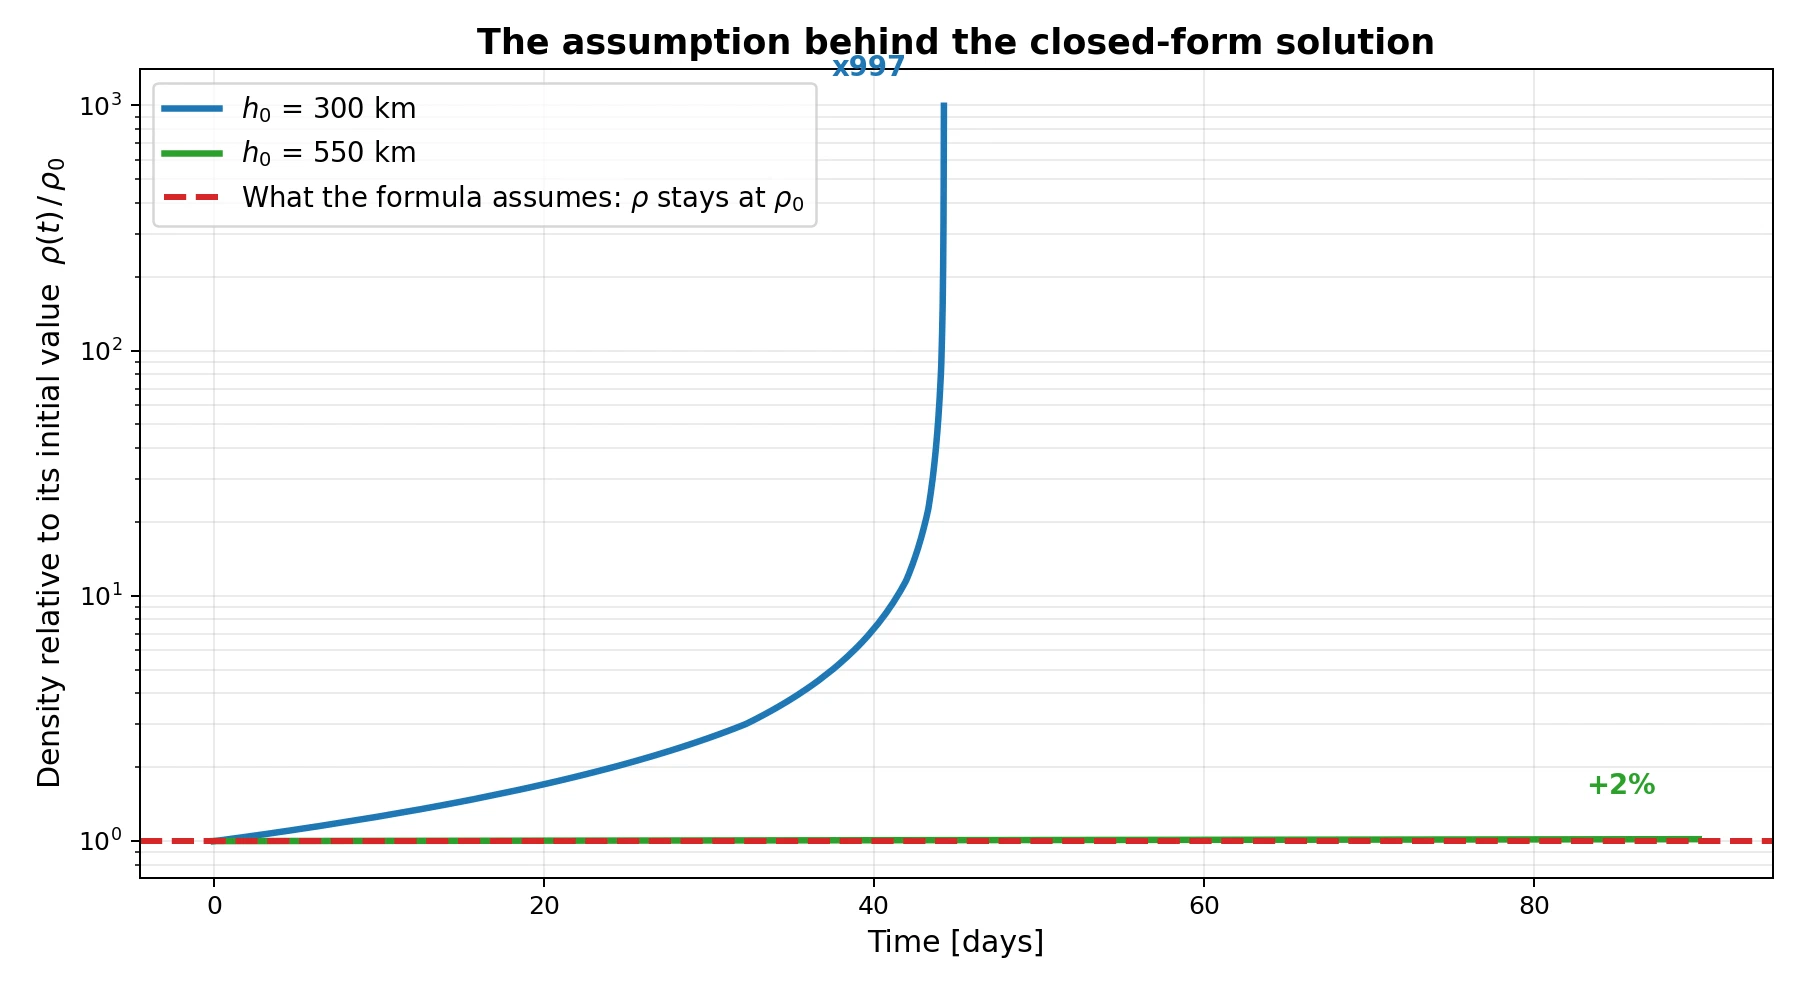
Para la trayectoria de 550 km y β = 100 kg/m², la suposición casi no cuesta nada: en noventa días la densidad real sube menos del 2%, así que la línea roja tiene razón todo el camino. Para la trayectoria de 300 km con el mismo coeficiente balístico, la densidad termina siendo 997 veces la inicial, y la fórmula nunca se entera.
Esta sola figura predice todo lo que sigue. Alto y lento: la solución clásica es casi exacta y no hay nada que mejorar. Bajo y rápido: hay una brecha, y es enorme.
El experimento#
Ya tenía un simulador orbital de seis grados de libertad construido en Simulink, así que lo usé para generar los datos.
La campaña fue una grilla: alturas iniciales de 300 a 600 km, coeficientes balísticos de 50 a 400 kg/m², órbitas circulares ecuatoriales, horizontes de noventa días. Veintiocho trayectorias completas, muestreadas cada diez minutos.
La cantidad a predecir es el decaimiento acumulado:
$$\Delta h = h_0 - h(t)$$
Hay una decisión acá que importa más de lo que parece. La separación es por trayectorias completas, nunca por puntos individuales. Dieciséis corridas para entrenar, cuatro para validar, ocho reservadas para la evaluación final. Separar por fila pondría muestras consecutivas de la misma trayectoria de los dos lados, y el modelo sacaría buen puntaje por interpolar entre puntos que ya vio.
Todo lo que sigue es regresión lineal múltiple con escalado de features, entrenada con batch gradient descent y learning rate 0,03. Sin árboles, sin redes, sin modelos de librería. Lo único que cambia siempre es el contenido de X.
Primer intento: contarle los números#
Empecé donde empieza el curso. Darle al modelo todo lo que sé y dejar que lo ordene:
$$\Delta h = w_1 h_0 + w_2\beta + w_3 t + b$$
RMSE de validación: 27,86 km. La función de costo convergió perfecto, y el modelo es un disparate.
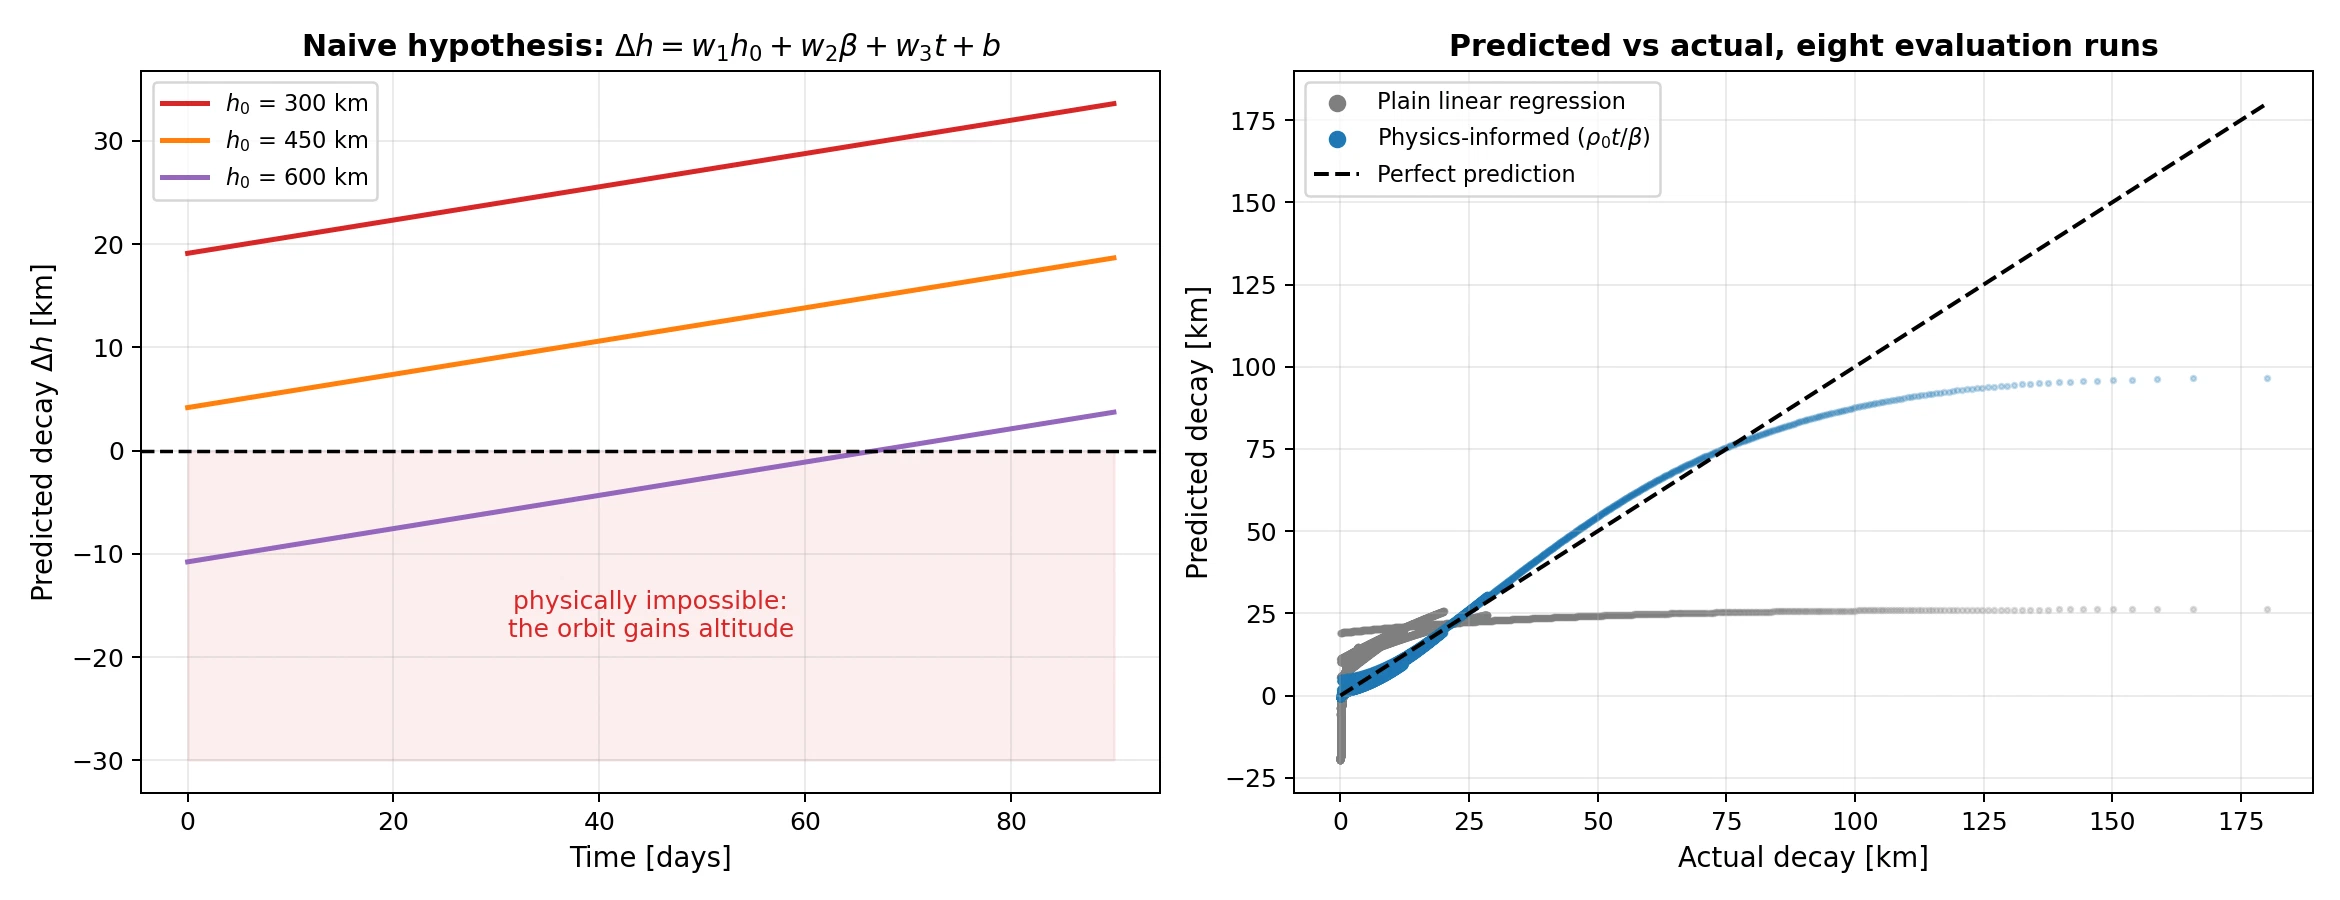
Mirá el panel izquierdo. A 600 km, el modelo predice que el satélite gana once kilómetros de altura. No es un error chico: es una respuesta físicamente imposible.
Hay dos fallas apiladas una sobre la otra, y las dos enseñan algo.
La primera es que el modelo es lineal en el tiempo, y el decaimiento acelera. Una recta trazada sobre una curva que termina vertical tiene que ser demasiado empinada al principio y desesperadamente insuficiente al final. Se ve en el panel derecho: la nube gris se aplana alrededor de los 25 km mientras el decaimiento real sigue subiendo más allá de 180.
La segunda falla es más profunda. El modelo es lineal en la altura. Pero la altura no actúa sobre el arrastre directamente: actúa a través de la densidad, y esa relación es exponencial a lo largo de ocho órdenes de magnitud. Pedirle a un único término lineal en h₀ que represente eso es pedirle a una recta que aproxime la curva de la figura de la atmósfera.
Probé agregando un término t². El RMSE de validación pasó a 27,88 km, apenas peor, e introdujo un problema nuevo. El peso ajustado sobre t² salió negativo, así que en horizontes largos la parábola se curva hacia abajo y el satélite empieza a subir de nuevo.
Segundo intento: contarle que los números interactúan#
El pensamiento siguiente es obvio: estas variables no son independientes. La altura cambia con qué intensidad actúa el tiempo. Así que en lugar de términos separados, productos:
| Hipótesis | Features | RMSE validación |
|---|---|---|
| Acoplada con β | t, t², h₀t, βt | 26,40 km |
| Acoplada con 1/β | t, t², h₀t, t/β | 26,29 km |
| Polinómica en altura | h₀, β, t, t², h₀² | 25,62 km |
Tres intentos. Una mejora del seis por ciento. Prácticamente nada.
Hay una buena noticia chiquita enterrada en esa tabla: la versión que usa t/β le gana a la que usa βt. La física dice que el decaimiento debería escalar con la inversa del coeficiente balístico, y los datos coinciden. El razonamiento físico apuntaba en la dirección correcta, aunque todavía no alcanzara.
Pero las tres hipótesis repiten el mismo error. Le siguen dando la altura al modelo. Agregar h₀² para perseguir una exponencial es una batalla perdida: necesitarías un polinomio de orden altísimo, y explotaría igual apenas te corrieras del rango ajustado.
Tercer intento: contarle la física#
La solución no fue un algoritmo mejor. Fue negarme a hacer que el modelo redescubriera algo que yo ya sabía.
No necesito que una regresión aprenda la estructura de la atmósfera. El modelo de Vallado ya está dentro de mi simulador y ofrece la referencia atmosférica usada de manera consistente en todo este experimento. Así que dejé de darle la altura y empecé a darle aquello que la altura realmente controla:
$$\rho_0 = \rho(h_0)$$
calculado con las 28 capas de Vallado, antes de que los datos lleguen a la regresión.
Después volví a la ecuación diferencial y leí la combinación que verdaderamente gobierna la física. La tasa de decaimiento depende de ρ dividido β, así que sobre un horizonte t la variable natural no es el tiempo, la altura y la masa por separado. Es:
$$x_1 = \frac{\rho_0 t}{\beta}$$
Agregué su cuadrado, para darle al modelo la curvatura que la solución de densidad constante estructuralmente no puede producir, y conservé términos adicionales para permitir ajustes residuales:
$$\Delta h = w_1\frac{\rho_0 t}{\beta} + w_2\left(\frac{\rho_0 t}{\beta}\right)^{2} + w_3\frac{t}{\beta} + w_4\rho_0 + w_5 t + w_6\beta + b$$
Seis features. Conservar términos independientes del tiempo ($\rho_0, \beta, b$) permitió reducir el RMSE en esta evaluación estática, aunque introduce una limitación conceptual que se vuelve crítica al utilizar el modelo de forma iterativa.
RMSE de validación: 7,03 km, contra 25,62 de lo mejor que había venido antes.
Eso no es una mejora incremental. Es otro régimen.
Lo que salió#
Sobre las ocho corridas reservadas, evaluando cada muestra de diez minutos:
| Modelo | RMSE | MAE | Error mediano |
|---|---|---|---|
| Regresión con física | 2,371 km | 1,128 km | 0,670 km |
| Fórmula clásica (un paso) | 6,783 km | 1,505 km | 0,017 km |
| Regresión lineal simple | 11,268 km | 7,727 km | 6,844 km |
El error absoluto medio pasó de 7,73 km a 1,13 km, superando a la fórmula clásica en esa métrica agregada. El error mediano pasó de 6,84 km a 670 metros, aunque la fórmula clásica conserva el menor error mediano, de 17 metros.
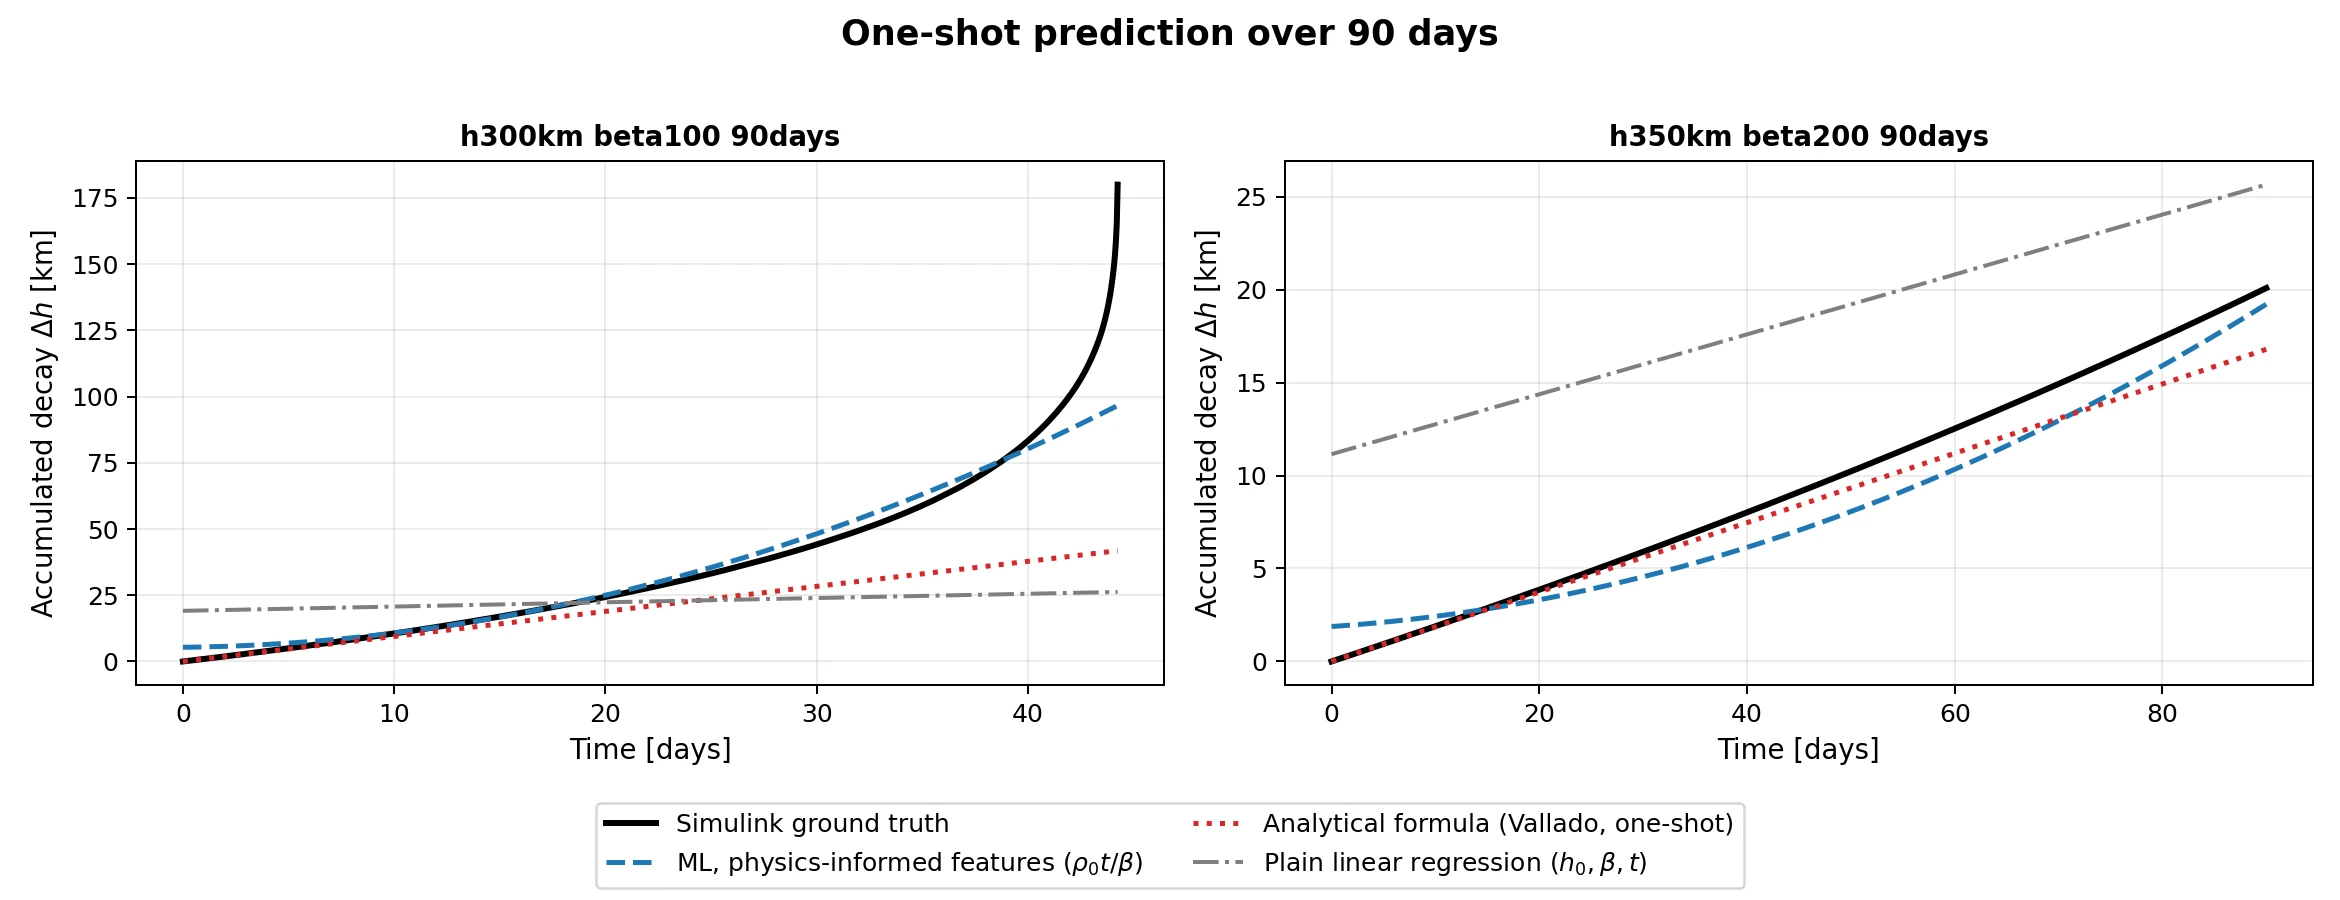
Esa diferencia importa. La fórmula clásica tiene el mejor error típico y el segundo peor RMSE al mismo tiempo.
No es una contradicción. Es una huella digital. Es lo que se ve cuando un modelo es casi perfecto en casi todos lados y catastrófico en un lugar específico.
Dónde gana cada herramienta#
Así que salí a buscar ese lugar.
Agrupar los errores por altura daba una imagen confusa. Agruparlos por t/β no mejoraba mucho. Lo que finalmente hizo que todo encajara fue agrupar por la cantidad acoplada que venía de la feature misma: ρ₀t/β, el parámetro físico de frenado.
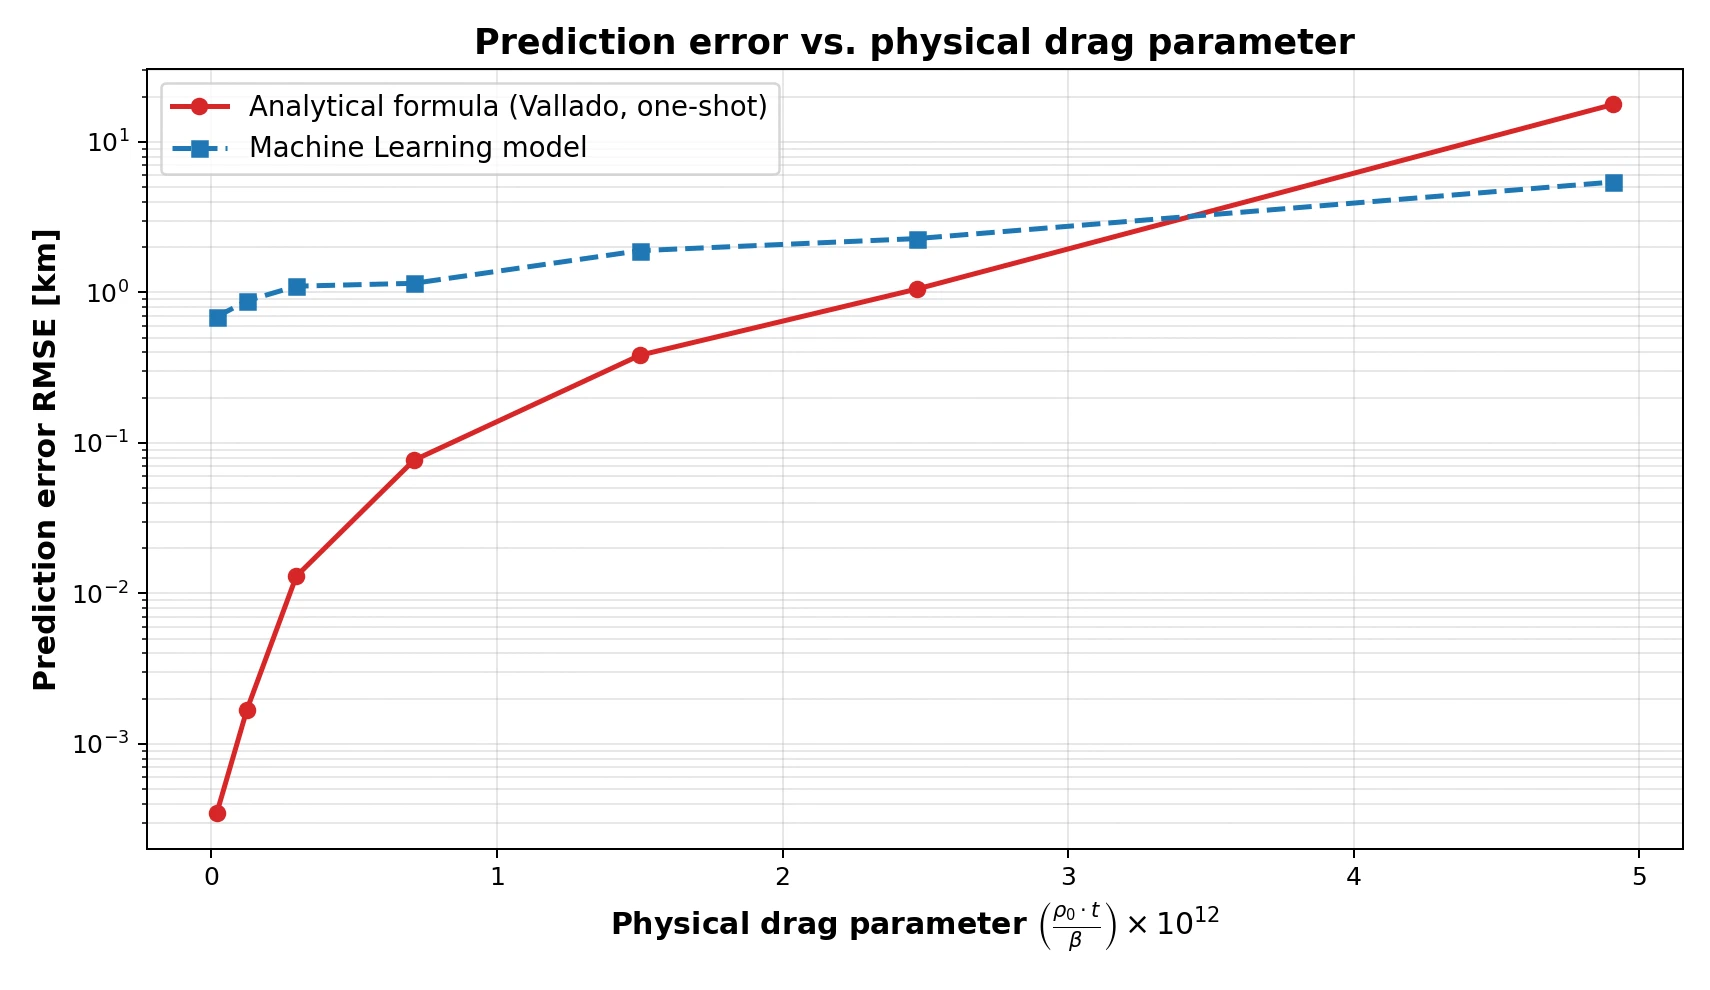
Por debajo del cruce, alrededor de 3,4×10⁻¹², la fórmula clásica es dos a tres órdenes de magnitud más precisa. Esto ocurre en órbitas altas (por encima de unos 500 km) o en horizontes temporales cortos, donde la densidad casi no varía y asumir $\rho_0$ constante no introduce error apreciable. El machine learning no tiene nada que aportar en ese régimen.
Por encima de ese umbral, el satélite experimenta un arrastre significativo (por ejemplo, en órbitas por debajo de 450 km o con coeficientes balísticos bajos a lo largo de varios meses). Al descender hacia capas más densas, la hipótesis de densidad constante deja de ser válida: el error de la fórmula clásica trepa a 17,8 km, mientras que el modelo aprendido mantiene un error cercano a 5,4 km, resultando hasta 4,5 veces más preciso en los regímenes más severos.
Con honestidad: el resultado más útil de este proyecto no es el modelo. Es ese umbral. Te dice qué herramienta agarrar antes de haber hecho ningún trabajo.
Bonus track: se rompió cuando lo usé dos veces#
Un último experimento, y es el que más me enseñó.
Todo lo anterior le hace al modelo una única pregunta: ¿cuánto decaimiento hay después de t días? Pero una herramienta real de planificación de misión funciona distinto. Avanza paso a paso, recalculando la altura, y por lo tanto la densidad, en cada paso.
El mismo modelo, usado de una segunda manera. Con pasos de un día:
| Modelo aprendido | Fórmula clásica | |
|---|---|---|
| Un solo paso a 90 días, MAE | 1,15 km | 1,54 km |
| Recursivo, pasos de 1 día, MAE | 61,53 km | 0,144 km |
La fórmula mejora. Aplicada paso a paso se convierte en un integrador de Euler de primer orden, su suposición solo tiene que sobrevivir un día por vez, y su error medio baja a 144 metros. Mi modelo se desarmó.
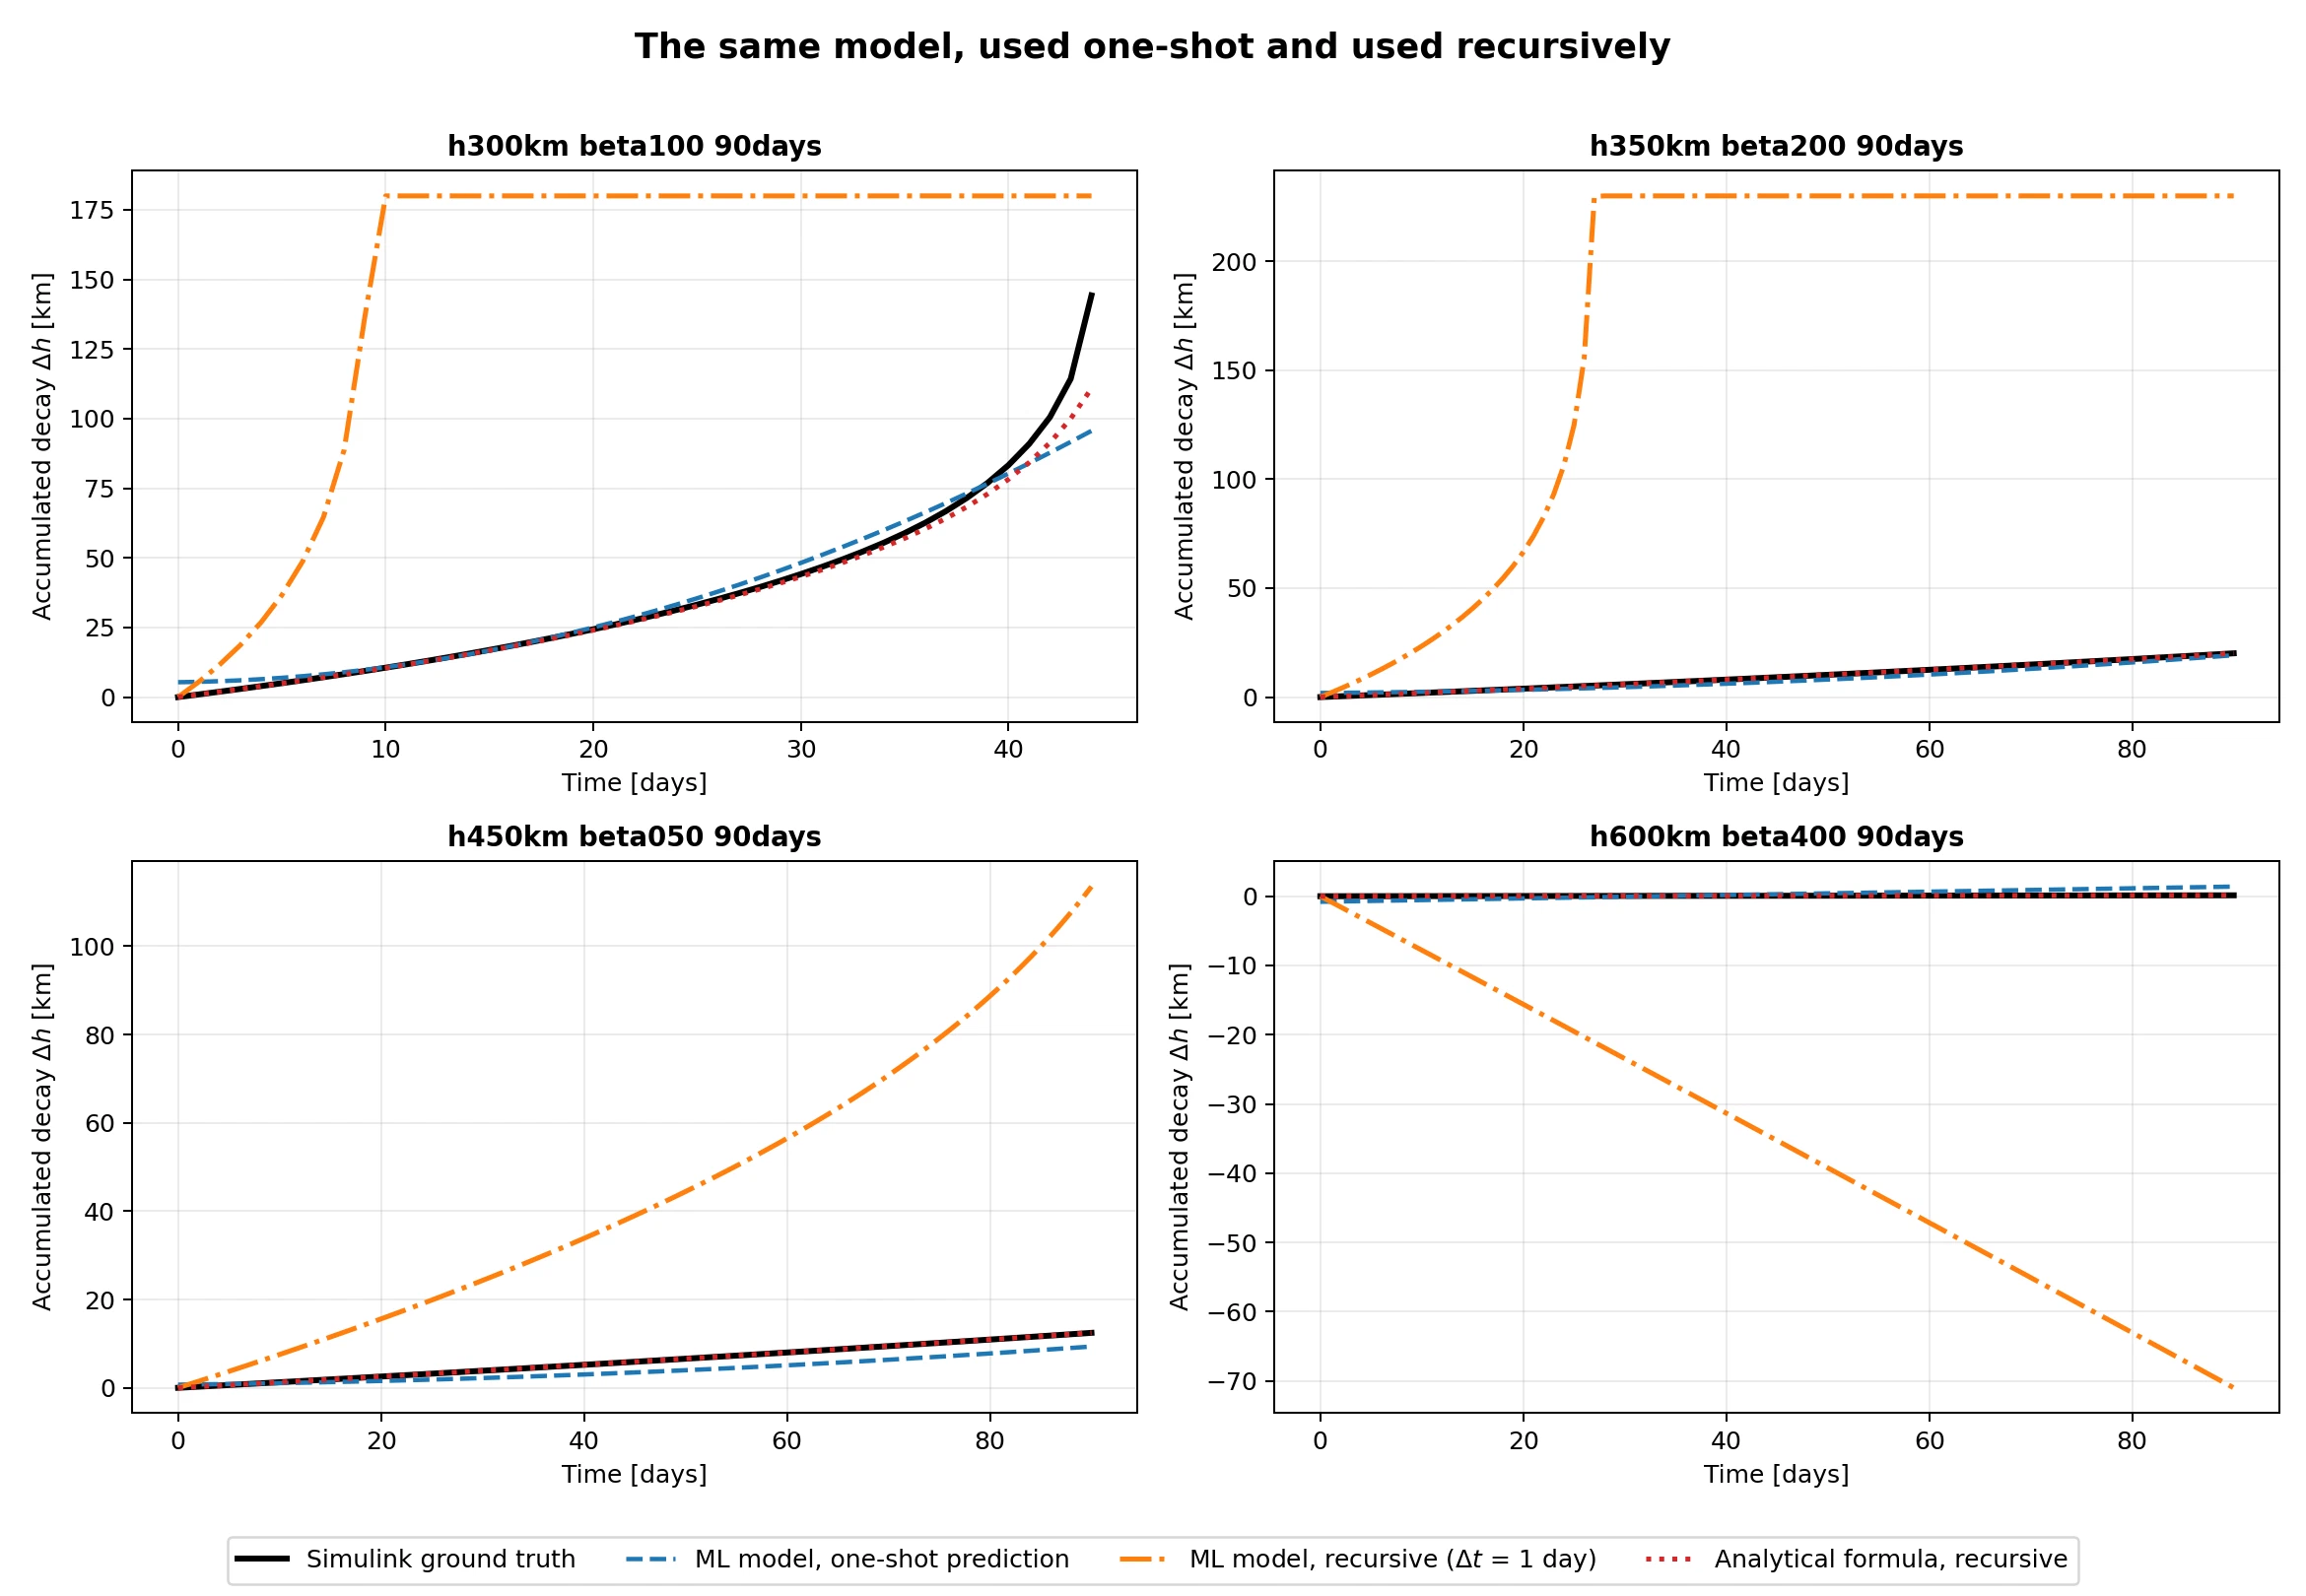
La explicación cómoda es que los modelos de machine learning acumulan error bajo recursión. También es una forma de no mirar.
La razón real está en la lista de features. Tres de esos seis términos (ρ₀, β y el intercepto b) no dependen del tiempo en absoluto. Así que si evaluás el modelo en t = 0, obtenés un número que no es cero. A 300 km, predecía 5,34 km de decaimiento antes de que pasara tiempo alguno.
Δh(0) = 0 no es una aproximación. Es una identidad. En un solo paso, ese desvío se esconde dentro de los promedios. En recursión se reinyecta en cada paso y además se realimenta, porque el decaimiento fantasma baja la altura de trabajo, lo que sube la densidad, lo que agranda el error del paso siguiente.
Corregirlo resultó ser, otra vez, puro feature engineering. Pero esa es historia para otro post.
Lo que me llevo#
El feature engineering es por donde entra el conocimiento del dominio. Todo el salto, de 7,73 km a 1,13 km, salió de reemplazar altura por densidad y armar ρ₀t/β. El algoritmo nunca cambió.
No hagas que un modelo redescubra lo que ya sabés. La atmósfera de Vallado ya es un modelo de referencia consistente para este experimento. Gastar capacidad del modelo en aproximarla habría sido desperdicio.
Una función de costo que converge no dice nada sobre si la hipótesis es correcta. La mía convergía perfecto mientras predecía que los satélites ganan altura.
Validá un modelo de la forma en que lo vas a usar. La precisión en un paso y la estabilidad paso a paso son propiedades distintas, y la brecha entre ambas fue de un factor de cincuenta.
Y sepamos cuándo no usar machine learning. Por debajo de 3,4×10⁻¹² la fórmula cerrada de hace un siglo gana, y no por poco. El modelo se ganó su lugar en un régimen específico, que es una afirmación más chica de la que salí a buscar y mucho más útil.
El simulador, la campaña de datos, los modelos y todas las figuras de este post son públicos: